目录
机器人的泛化难题
2026 年 8 月,Dyna Robotics 公布了一组实验室与客户现场的对照。在内部评测中,Dyna-1 和 Dyna-2 都接近 100% 达标;放到训练时没见过的客户场景,按客户对质量、效率和可靠性的要求验收,两者的通过率分别是 46% 和 87%。两代模型使用了相同的任务后训练数据和训练步数。[1]
这组结果既显示了进步,也说明了机器人泛化的困难。在训练场景学会一套演示动作之后,机器人还很难适应新的场地、物体和操作条件。
在日常家务中,拿起杯子,需要选抓取位置、判断杯子是否会滑、在接触后调整力度,这些都可能遇到训练中没有见过的情况。模型即使“认得杯子”、“理解”拿起来这条指令,也可能在执行中失败。
语言模型和视频生成模型已经在不少任务中表现出较强的泛化能力,为什么预测动作的模型依然受限?这是本文讨论的重点。如果您也在实验中遇到类似的困惑,不妨继续看下去。
后面两节介绍模型和规模定律的基础背景。如果您已经熟悉 VLA、WAM 和 Scaling Law,可以直接阅读动作预测的误差来源。
VLA 与 WAM
视觉-语言-动作模型(VLA)把摄像头画面、语言指令和机器人自身的状态作为输入,生成动作。许多 VLA 继承了大规模预训练的视觉语言模型,再增加动作输出模块。动作可以表示为末端执行器的位姿变化、关节目标或一段连续轨迹,由控制器转换为执行指令。[2],[3],[4]
世界-动作模型(WAM)还学习预测未来的观测。以 Dyna-2 为例,视频和动作使用不同的表示与网络模块,并通过注意力交互;用于规模实验的模型同时接受视频预测和动作预测训练。视频任务能够影响共享表示,实际控制时则可以直接生成动作。[1]
这些模型广泛采用模仿学习,其中常用的方法是行为克隆(Behavior Cloning):记录演示者完成任务时的观测与动作,让模型根据画面、任务描述和机器人自身状态预测动作。数据可以由人遥操作机器人采集,也可以来自手持夹爪、可穿戴设备或人类操作视频。后几种方式减少了对机器人本体的依赖,同时带来了动作标注和跨本体迁移的问题。
强化学习通过行动后的奖励改进策略,可以使用仿真或真实机器人的交互数据。它与行为克隆也能结合:用演示得到初始策略,再用策略自己的执行记录、纠正和奖励继续训练。[5]
预训练、模仿学习与强化学习各自提供不同的经验。视觉语言模型学过大量物体与概念,演示记录了人如何操作,交互数据则包含机器人执行动作后得到的反馈。模型要把这些经验用于新的物体和任务,仍需要学会当前观测与动作之间的关系。
机器人的规模定律
语言模型的规模定律提供了一个有吸引力的参照。Kaplan 等人在 2020 年发现,在所研究的范围内,语言模型的测试损失随模型规模、数据量和计算量呈现较稳定的幂律关系。[8] 后来的 Chinchilla 研究进一步讨论了固定计算预算下,参数量与训练数据如何配比。[9]
把数据规模与损失的关系简写为:
L(D) ≈ k · D−α + L∞
这里,D 是数据量,α 描述可改善部分随数据增长而下降的速度,k 决定其量级,L∞ 是拟合中的渐近损失项。数据每翻一倍,L(D) − L∞ 就乘以 2−α。在双对数坐标上呈直线关系的是这部分可改善的损失;把非零的渐近项也算进去,曲线会逐渐变平。
机器人研究正在检验类似关系,但“数据量”包含了差别很大的材料。RoboTurk 公布过 111 小时遥操作数据,DROID 约 350 小时,AgiBot World 约 2,976 小时。Qwen-RobotManip 对九个主要开源机器人数据集的统计合计约 11,000 小时。[10],[11],[12],[13] Dyna-2 的预训练规模则超过一百万小时,主要来自第一人称人类操作视频。[1]
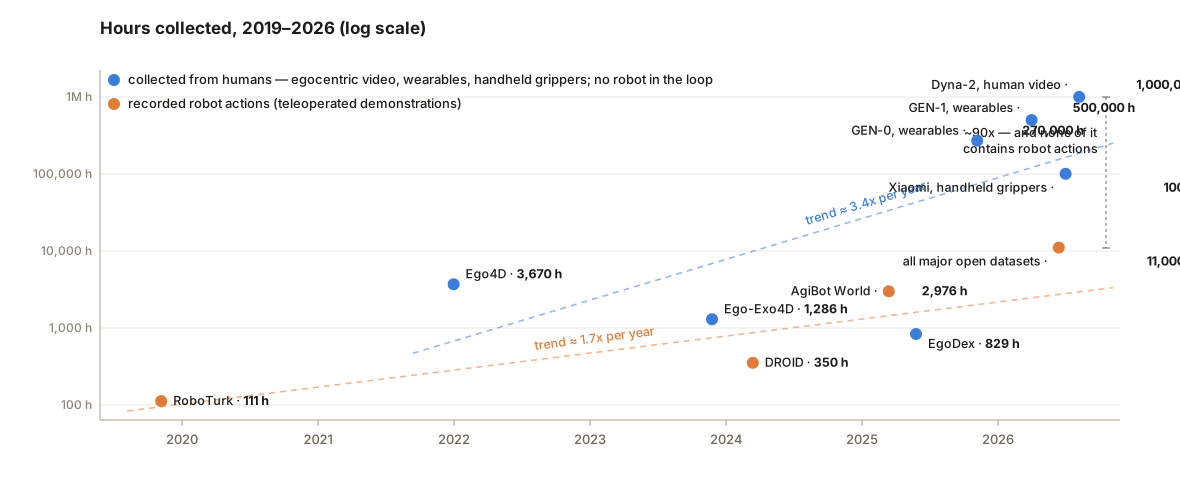
不同采集方式的数据规模。橙色为机器人动作记录,蓝色为人类操作数据。[10],[11],[12],[14],[15],[16],[17],[18],[19] 数据来源、传感器和标注方式各不相同;图中的趋势线仅描述这些公开样本,不代表行业整体增长率。百万小时商业语料与开源数据集总量也不构成同口径比较。
一小时人类视频与一小时机器人遥操作数据,能提供的动作监督不同。前者往往要从手腕轨迹、手指距离或设备读数中提取动作;后者记录的是指定机器人执行任务时的指令和状态。小时数能够反映采集规模,还需要结合标注质量、任务覆盖和身体差异判断训练价值。
模型参数量也有类似限制。GR00T N1 为 2.2B,π0 约 3B,OpenVLA 为 7B;RT-2 曾使用 55B 主干。[20],[4],[3],[2] OpenVLA 在论文评测中超过了更大的 RT-2-X,但两者的数据与训练方案不同,不能据此单独判断参数规模的作用。机器人还受到控制频率和推理延迟的约束,扩大模型要同时考虑执行速度。[7]
Dyna-2 的消融更直接地考察了训练目标。研究者从带手部姿态标注的人类视频中提取伪动作,使用 5,000、50,000 和 100,000 小时数据,比较仅预测动作、联合预测视频与动作,以及额外加入无动作标注视频的训练方式。在 39 个机器人任务的零样本离线评测中,仅动作训练出现了严重且不稳定的过拟合;加入额外视频预测数据后,跨本体迁移才随数据量增长而稳定改善。[1]
这项结果说明,在这套数据、架构与评测条件下,训练目标和数据组成影响了规模收益。要解释原因,需要进一步看动作标签本身。
动作预测的误差来源
训练数据中记录了演示者执行的动作,却未必记录了他为什么这样做。一个人决定从杯柄右侧伸手,可能因为左侧有障碍,也可能只是习惯。两种情况都能留下相似的动作标签,模型要靠输入中的信息区分它们。
这里用 xt 表示模型收到的观测历史、任务指令和机器人自身状态,at 表示演示动作,ot+1 表示下一步观测。摄像头拍到的画面只记录了部分物理状态。演示者的绕行选择、操作习惯和接触时感受到的力,也未必包含在这些输入中。
隐藏状态
两个人在同一位置绕过障碍物,一个选左侧,一个选右侧。在分叉发生前,两段位置历史可以完全相同。如果模型只收到“前往目标 O”的指令,就无法从这些输入确定演示者会选哪一侧。
如果补上一句“从左侧绕行”,选择就明确了。如果演示者每次都临时随机选择,记录里又没有任何线索,多收集一些演示可以帮助模型学到左右选择的比例,仍无法预测某一次随机选择。这区分了两件事:学会可能的动作分布,以及猜中某条记录里的具体动作。左右两条路径都能完成任务时,机器人只需选定并执行其中一条。
视频预测在什么情况下会更容易?假设模型已经知道接下来要执行的动作,就可以根据动作预测场景变化。例如,给定“向左移动”的控制量后,绕行方向已经确定,模型可以学习位置如何随运动变化。两项任务的条件分别是:
动作条件下的未来预测:p(ot+1 | xt, at)
动作预测:p(at | xt)
动作条件提供了已经作出的选择,动作预测需要从观测中学习如何作出选择。Genie 就使用历史视频和潜动作预测下一帧,其中的潜动作从视频变化中学得,并可在生成时由用户指定。[26] 这类设计能减少未来预测中的一部分不确定性。摩擦、接触位置等条件仍可能缺失,给定动作也不能保证预测完全确定。
不过,WAM 的具体训练方式需要逐一检查。Dyna-2 用于规模实验的版本,共享主干、分别训练视频和动作的流匹配目标;两项任务使用相同的历史条件,视频分支没有直接接收真实的未来动作。[1] 因此,这组实验不能直接归因为视频预测多拿到了一个 at。一般的视频生成也常常要同时建模多种可能的未来。[25]
输入遗漏了动作选择的条件,模型就只能根据已记录的信息学习动作分布。样本有限时,它可能把某个场景中的偶然细节与一次动作选择绑定,训练 loss 继续下降,换一批演示后却预测得更差。 这是一条可能导致过拟合的路径,需要分别验证信息缺失、样本覆盖和训练行为。仅凭动作与视频两条 loss 曲线,还不能确定原因。
我们做了一个简单的二维绕障仿真,观察隐藏选择会怎样影响预测。每条演示随机选择绕行侧,并带有转弯早晚的风格差异与指令抖动。两个模型都接收最近两次位置:观测预测头预测下一位置,对应图中的 vision head;动作预测头预测原始动作指令,对应 action head。这里的观测预测头只是位置回归模型,与 VLA 的视觉编码器、WAM 的视频生成分支都不同。[21]
仿真还设置了惯性:执行速度由上一时刻的速度和当前指令共同决定,短暂的指令抖动会被平滑。因此,预测原始指令与预测运动后的位置,受到扰动的方式不同。两种目标的误差要分别解释。
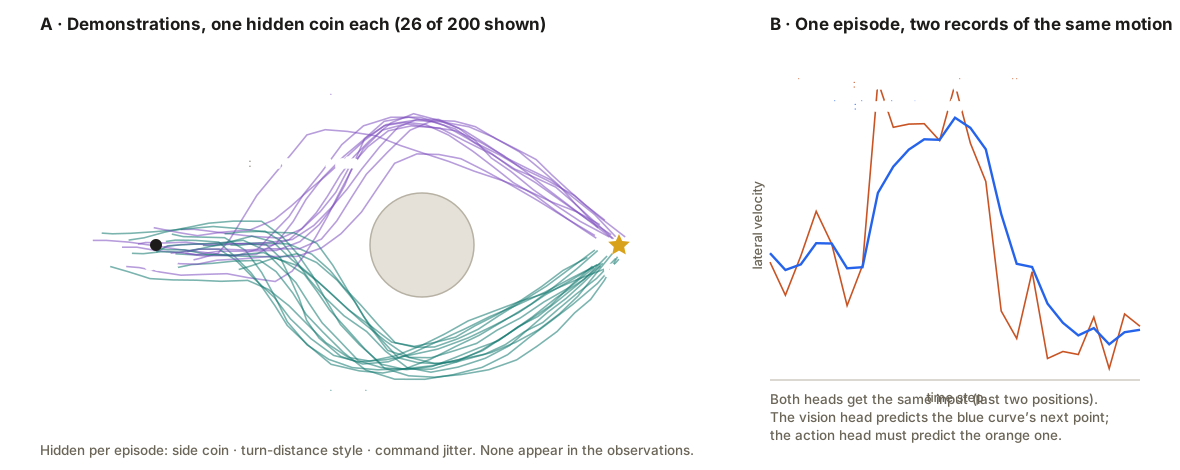
左图显示绕行侧与转弯风格,右图比较原始指令和执行后的运动。两个预测头都未接收当前动作、绕行侧和风格参数;本实验没有检验“给视频预测增加动作条件”的效果。
仿真设置与隐藏变量消融
# 每个回合隐藏的变量:side(绕行侧)、turn_dist(转弯距离)。
if x < OBS_X and (OBS_X - x) < turn_dist and abs(y) < 1.0:
    target = (x + 0.5, side * 1.2)
else:
    target = GOAL
d = unit_vector(target - pos)
cmd = SPEED * d + gauss(0, 0.05)
exec_v = 0.6 * exec_v + 0.4 * cmd
pos = pos + exec_v

# 两种预测均使用最近两个位置:
# 观测预测头:pos_next
# 动作预测头:cmd
# 最近邻:200 个训练回合、200 个验证回合。
# 小型 MLP:4 -> 240 tanh -> 2;另做 8 与 200 回合的对照。
仿真用归一化均方误差(NMSE)衡量位置或指令的预测偏差:
NMSE = E‖ŷ − y‖² / Var(y)
向量目标的 Var 表示各维方差之和。这个指标只用于下面的简单回归实验,不能把它的优化行为直接推广到扩散或流匹配策略。
用最近邻模型分别拟合两种目标,200 个训练回合上都可以达到零误差。换成 200 个新回合,动作 NMSE 为 0.631,观测 NMSE 为 0.0033。两者相差约 190 倍,但各自的归一化分母不同,这个倍数不能直接解释成泛化能力差距。
逐项移除隐藏变量,可以进一步比较:
| 仿真条件 | 动作 NMSE | 观测 NMSE |
|---|---|---|
| 隐藏绕行侧、风格和抖动 | 0.62 | 0.003 |
| 仅保留指令抖动 | 0.36 | 0.002 |
| 仅保留隐藏决策 | 0.28 | 0.001 |
| 保留全部隐藏因素,改为预测执行后的速度 | 0.22 | 0.003 |
这些结果来自作者的仿真。[21] 0.62 与前述 0.631 来自不同运行。表中报告的是预测误差,不能直接当作不可约误差下限;改变目标后,归一化分母也会变化。
关闭指令噪声后,隐藏的绕行决策仍会造成预测误差。改为预测执行后的速度,目标经过了惯性平滑,误差和归一化分母都会变化。观测目标中的位置与惯性运动又能从历史中预测,使得总体误差较低;这些数值不构成视觉比动作更能泛化的证据。
本仿真不包含图像编码、复杂接触或真实机器人控制。以上代码只展示单步更新,完整训练、采样和统计脚本尚未随文提供。[21]
接触中的状态缺失
前面的绕障例子假设左右两侧都能通行。如果其中一侧有摄像头看不到的阻挡,绕行选择也会影响任务能否成功。类似的信息缺失出现在许多任务中,接触操作就是一个例子。
外观相近的两个杯子,重量和表面摩擦不同,需要的握力也可能不同。演示者用手能感觉到杯子开始滑动,模型若只收到同一视角的图像,就缺少这次加力的依据。FACT 对接触密集任务的分析区分了力控制失败与其他视觉、位置精度问题。[22]
触觉和力反馈能够补充这类观测,但采集规模仍有限。T-Rex 报告了约 100 小时触觉操作数据,与百万小时视频语料相差很大。[23] 具体任务对触觉的依赖程度不同;视觉中的形变、运动历史和主动试探也能提供部分物理信息。
接触还会放大未观测的微小差异。在文中的粘滑仿真中,摩擦参数变动 ±1%,系统接近静摩擦阈值时,位移结果的散布约为平滑阻尼对照的 83 倍;远离阈值后,差异大幅减弱。[21] 83 倍是这套仿真的结果,不能换算为真实机器人误差的统一放大率。平面推物的硬件研究也测到了重复相近操作时的结果分布。[24]
摩擦和接触位置同样影响动作执行后的画面。缺少这些信息,视频预测也会遇到困难。比较动作与视频的泛化表现时,需要先确认两者的输入包含哪些状态,哪些决定预测结果的条件仍然缺失。
偶然关联与过拟合
模型会怎样利用一份信息不完整的演示?假设训练集中碰巧是蓝桌面上的演示都向左绕,白桌面上的演示都向右绕,而任务允许两侧通行。桌面颜色就能帮助模型降低训练误差。换一张桌子、换一位演示者,这个关联便可能失效。对更复杂的输入,网络还可能通过微小的位置差异辨认某段训练轨迹,记住其中的动作和抖动。
这就解释了“记住噪声”在这里指什么。一次抖动成了训练标签的一部分,模型利用样本中的偶然特征去拟合它;这些特征与下一次抖动之间没有稳定关系。如果模型继续加强这类对应,训练 loss 可以下降,验证 loss 却会上升。随机标签实验说明深度网络有能力记住缺乏真实规律的对应,关于记忆过程的研究也观察了规律学习与样本记忆的差异。[27],[28] 它们支持这种机制的可能性,具体机器人模型是否如此仍需消融验证。
Diffusion Policy、π0 和动作 token 模型都能表示多种可能的动作。[29],[4],[2] 对左右均可绕行的任务,模型可以学习两种选择并采样执行;对需要根据重量调整握力的任务,动作分布再丰富,也无法凭空获知这一次杯子的重量。
分布模型也可能把概率过度集中到训练样本中的动作上。模型能否表示多峰分布,与它能否在新条件下学准这个分布,是两个问题。流匹配中的平方误差用于学习去噪速度场,不能按“把左右动作求平均”理解它的最终输出。[4]
信息不完整也不必然导致验证 loss 回升。只要模型学到了输入所能支持的稳定规律或动作分布,验证表现就可能趋于稳定。过拟合还与数据覆盖、模型容量和训练过程有关。下面的小型回归实验只能展示其中一条路径。
文中的小型 MLP 只用八条演示训练了 4,000 个 epoch。观测训练与验证 NMSE 分别达到 0.0014 和 0.0019。动作验证误差在第 45 个 epoch 降到约 0.53,此后回升到约 0.60,训练误差降到约 0.31。[21]
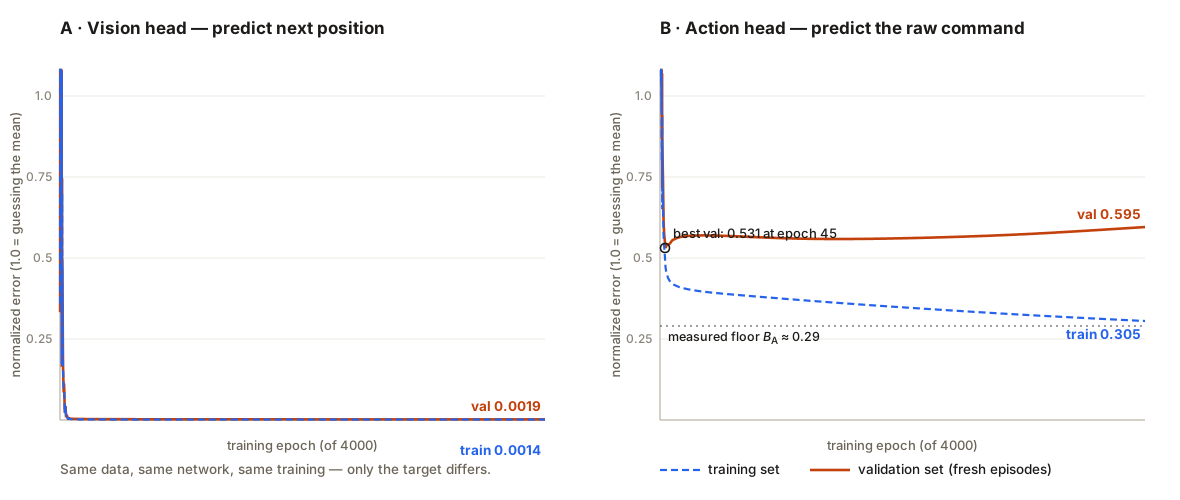
动作验证误差先下降后回升,体现了这次训练中的过拟合。图中 floor 是根据局部条件方差估计的回归误差下限,只对应这套输入、目标和 NMSE 指标。它不约束现代生成式动作模型的任务成功率。
补充信息与样本数量的交叉对照
再把隐藏的绕行侧与风格交给模型,结果取决于数据量。最近邻模型的动作验证误差从约 0.62 降到 0.38。八回合 MLP 却出现更严重的过拟合:训练误差降到 0.12,验证误差升到 8.7。样本太少时,固定的风格参数可能成为识别某个训练回合的线索。
训练数据扩大到 200 回合后,提供隐藏变量的 MLP 验证误差降到 0.41,未提供隐藏变量的版本为 0.48。[21] 更多回合扩大了风格与轨迹的覆盖范围,降低了仅靠回合特征记忆的收益。仅凭这些曲线,仍不能确认每个模型具体使用了哪些内部特征。
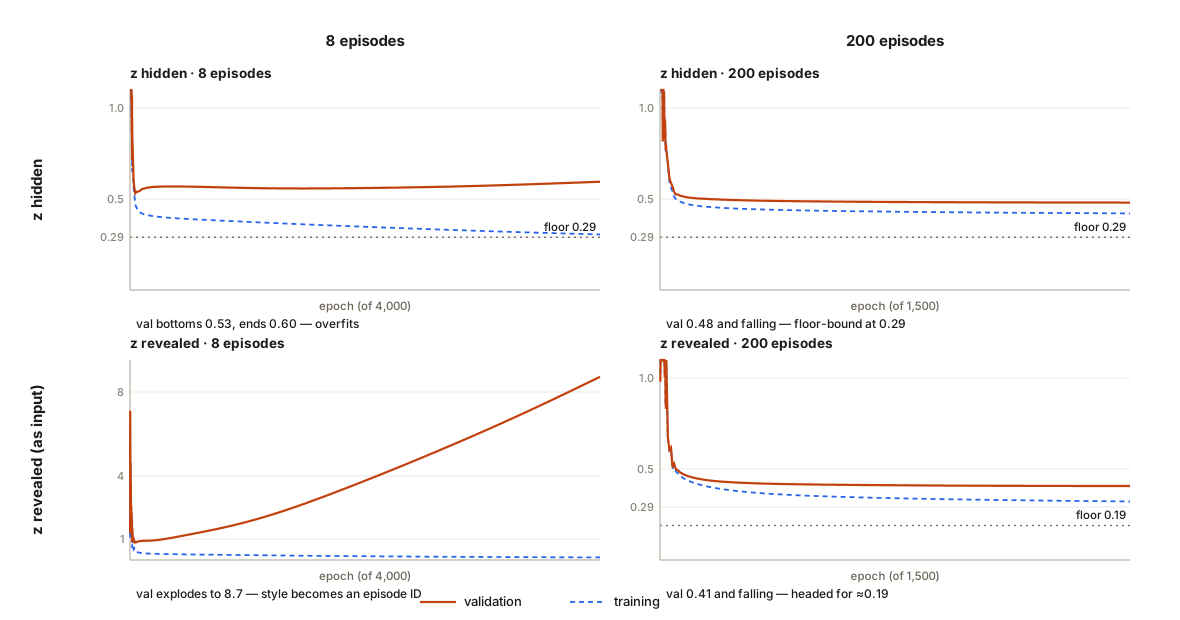
四组结果同时改变输入信息和样本覆盖,显示了两者的相互影响。图中约 0.19 的下限由最近邻结果作近似推断,确定它需要独立的条件方差估计。
演示数据的覆盖范围
如果训练里只有几种场景和操作习惯,模型很难判断哪些线索在新任务里仍然有效。增加演示能改善这一点,具体收益取决于新数据带来了多少不同的条件。
例如,一次持续两秒的平移可以被记录成几十帧。相邻画面和动作非常接近,主要重复了同一段运动中的条件。提高采样频率会增加帧数,也有助于捕捉快速变化,却不会自动增加绕行选择、物体重量或接触方式的种类。视频帧和动作标签都存在这种时间上的重复。
在绕障仿真中,训练帧数固定在约 170 帧时,把数据从八个回合分散到十六个回合,动作预测头的验证 NMSE 从 0.85 降到 0.76;增加到三十二个回合后约为 0.75。保持八个回合、只把帧数减半,动作验证 NMSE 则从 0.85 变为 0.88。[21] 这组对照中,增加不同回合比在同一批回合内保留更多相邻帧更有效,因为不同回合包含了新的绕行和转弯组合。
真实机器人研究进一步比较了环境和物体的覆盖。Lin、Hu 等人收集了四万多条演示,进行了超过一万五千次真实机器人执行测试。在他们的任务中,增加环境与物体种类,比持续重复同一组条件更有帮助;部分实验在每个环境与物体组合约五十条演示后,收益已明显减弱。[30]
这项研究考察的是换环境、换物体后的泛化。每条新演示内部的相邻帧仍然相似,增加的是训练集所覆盖的物体、背景和操作条件。同样是抓取杯子,模型在不同位置、不同杯子和桌面上反复完成任务,才有机会区分哪些动作依据能够跨场景复用。
AgiBot 的研究也发现任务多样性的价值,并讨论了不同操作员习惯给训练带来的干扰,针对速度差异的去偏处理有所帮助。[32] MimicLabs 则分析了摄像头位姿和空间布局等变化的作用。[33] 这些工作都在检查一件具体的事:新增数据改变了哪些条件,这些变化是否改善了对应的泛化测试。
小时数因而不足以独立衡量动作数据的训练价值。同一场景的额外演示可以补充精细纠偏或罕见的接触过程;换场景则能检验先前学到的关系是否仍然成立。已有条件重复得越充分,越需要明确下一批数据准备补上什么。
预训练知识的迁移限制
视觉语言预训练提供了比机器人演示广泛得多的知识。一个模型已经认识杯子和杯柄,加入动作训练后,为什么仍可能在换个杯子、换个视角时失败?这要检查知识在训练中是否被保留,以及学到的表示能否用于新的本体和操作条件。
联合训练与知识保留
动作输出出错,失效的位置可能在更早的视觉处理阶段。一项视角迁移研究将特定失败定位到视觉 token,并在冻结策略的条件下通过小型适配器改善表现。[6] 这提供了一个对照办法:分别检查输入表示与动作模块,避免只看到动作失败就认定问题出在动作头。
Dyna-2 的结果支持视频预测对跨本体迁移的帮助。[1] 丰田研究院的一项研究则比较了 89 个策略,进行了 58,000 次仿真和 2,835 次真实机器人执行测试。视觉语言数据、轨迹语言标注与跨本体机器人数据等有效组合,改善了分布变化、未见任务和指令跟随表现;仅用机器人数据训练时,主干的视觉语言能力有所退化。[31]
Physical Intelligence 的 Knowledge Insulation 研究关注动作专家与预训练主干之间的干扰。直接加入未训练的连续动作模块,可能损害训练速度和知识迁移;隔离相关梯度,并为主干保留合适的监督,能够缓解这类问题。[7]
这些实验把迁移困难定位到了输入信息之外的另一个环节:预训练知识进入动作学习后,还会受到训练目标与梯度更新的影响。即使原始输入里有可用的线索,训练后的表示也可能没有保留或利用好它。
动作表示的收益同样依赖训练条件。丰田研究院比较的离散动作 token 方案没有带来统计显著的增益,部分方案还降低了泛化表现。[31] 这限定了相关方案在该实验中的效果,不能据此否定动作分块、分布建模或其他表示在不同任务中的作用。
人类视频的跨本体迁移
Dyna-2 在 1,000、10,000、100,000 和 1,000,000 小时的人类视频子集上训练,保持数据来源比例、验证集和训练设置一致。人类留出集与未参与预训练的机器人数据上,离线动作指标都随预训练数据增长而改善。[1]
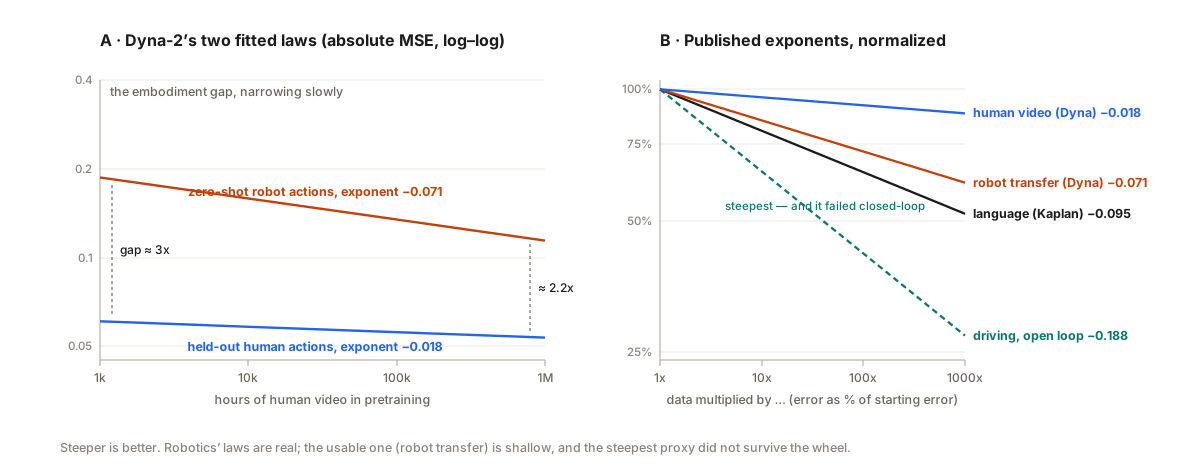
左图比较 Dyna-2 的同本体评测与跨本体评测,右图汇总不同研究的拟合指数。[1],[8],[34] 各研究使用的损失、单位、任务和拟合范围不同,曲线只能展示各自的变化趋势,不能按斜率直接排列模型的泛化能力。
Dyna-2 报告的人类动作与机器人动作误差仍有差距,跨数据规模约为两到三倍。这说明同本体和跨本体的预测效果仍有区别,具体差异要结合两组数据的任务和动作表示理解,不能直接换算成任务成功率。
迁移需要完成具体的动作映射。Dyna 从视频中提取手腕位姿,用作末端轨迹监督;从拇指和食指的距离构造连续抓握信号。[1] 这些标签提供了与机器人动作相近的表示,但仍未完整记录机器人自身的动力学、接触力和执行误差。手部动作映射到双指夹爪与灵巧手,也需要不同的处理。
本文对公开规模点作过带渐近项的重拟合,得到的外推范围很宽。[35] 数据只覆盖四档规模,拟合结果对函数形式与渐近项敏感。现有曲线支持继续检验人类数据的迁移收益,尚不足以预测再采集多少小时就能消除身体差异,更无法据此估算达到人类水平的时间。
新任务的适配信息
预训练带来的迁移,仍需结合模型在新任务上额外获得的信息来判断。少量示教可以补上目标摆放、动作顺序或特定本体的操作方式,因而要区分直接迁移、上下文示教和参数微调。
在 Dyna-2 的真机规模实验中,研究者对不同预训练规模的模型,使用相同的十四项任务数据进行后训练,每项任务最多十小时。保持这些数据不变,扩大人类视频预训练仍带来了真机收益:锁箱转钥匙任务在十万小时预训练时为 0/10,百万小时为 9/10。[1]
在这项对照里,机器人示教量保持不变,更广泛的人类预训练改善了后续学习。测到的收益来自“人类预训练加任务后训练”这一设置;仅凭这组结果,还不知道完全去掉机器人示教后的表现。
适配所需的信息量已经在变化。Generalist 的 GEN-1.5 报告,在上下文中加入一段 3 至 12 秒的感知与动作演示,不做梯度更新,十个任务的平均成功率为 59%,报告的标准差为 10%;使用每任务五分钟数据进行十步梯度更新后,平均成功率为 83%,标准差为 9%。这些“±”数值表示标准差,不能读成 95% 置信区间。[36]
该演示可以由手持夹爪采集,也可以来自机器人执行记录,包含传感器数据和动作轨迹。研究者限定这些实验为简单、短时任务,并说明上下文适配得到的技能仍比微调模型脆弱。[36] 因而,这项结果支持用短演示完成部分任务适配,不能概括为任意视频都能教会机器人一项技能。
任务经验还可以在部署中继续积累。Physical Intelligence 的 RECAP 使用策略执行结果、纠正和奖励改进模型。[5] 这让数据采集覆盖策略自己遇到的状态。它能否减少后续人工示教,要结合接管次数、失败恢复和采集成本评估。
执行偏差与状态分布
还有一种泛化困难会在执行中产生。机器人第一次抓取稍微偏了一点,杯子滑到新的位置,下一步就需要从这个位置重新接近。如果训练只包含顺利抓起杯子的演示,模型可能从未学过这样的纠正动作。即使物体和场地都没有换,机器人自己的误差也会把它带到训练数据很少覆盖的状态。
开环评测把模型放在记录好的轨迹上,逐步比较预测与演示动作。它每一步都接收演示者留下的状态,模型刚才预测错了,下一步仍然回到记录好的输入。闭环执行则延续模型自身动作造成的结果,需要处理偏离后的状态。只检查开环 loss,就会漏掉这部分泛化要求。
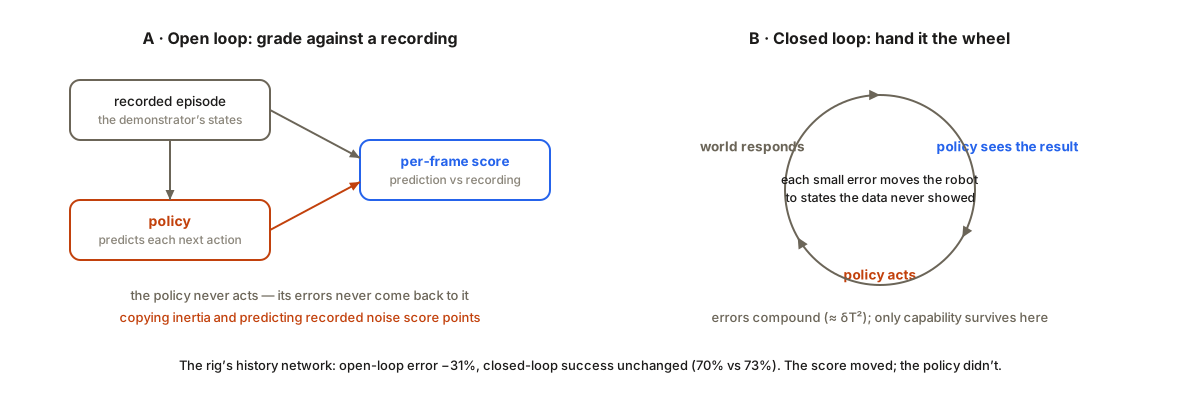
开环误差在演示者访问的状态上计算;闭环结果取决于学习策略实际访问的状态。动作偏差能否纠正,需要通过后续执行观察。
用符号表示,开环损失通常对专家状态分布 dexpert 取平均;部署表现取决于策略 π̂ 产生的状态分布 dπ̂。策略可能在专家轨迹附近预测准确,却不擅长从自身偏离后的状态恢复。
历史输入还可能提供与任务无关的预测线索。动作具有时间相关性,复制上一动作在离线记录上可能得分不错。Copycat 研究分析了模型依赖历史动作线索、弱化当前观测的现象;因果混淆研究则讨论了模仿学习中相关性与实际控制原因的错配。[37],[38]
LIBERO-PRO 在标准基准之外扰动物体、初始状态、指令和环境,发现原先高分的模型在一些泛化设置中降到 0%。模型在目标物体被替换、指令被破坏后,仍可能执行类似动作。[39] 另一项研究分析了多来源机器人数据中的捷径学习,模型可能利用背景和身体线索识别数据来源。[40] 这些结果支持检查模型是否跟随任务条件,具体失效位置仍需要消融定位。
文中的绕障仿真也做了开环与闭环对照。两个网络都用一百条演示训练,其中一个额外接收上一条原始指令;指令噪声设为具有时间相关性的低频漂移。额外历史输入把开环 NMSE 从 0.414 降到 0.287,约改善 31%。各做二百次闭环测试,成功率分别为 70% 和 73%。[21]
在这个样本量下,三个百分点的差异不足以确认稳定收益。它也不能证明收益恰好为零,或把全部开环改善都归因于噪声预测。可以确定的是,31% 的开环误差下降没有对应到同等幅度的任务成功率提升。
自动驾驶研究也报告过指标差异。一项三万小时数据的模仿学习研究观察到开环性能随数据呈幂律改善,但同样的关系未出现在闭环仿真中。[34] Waymo 另一项基于五十万小时数据的研究则报告,闭环指标也随规模增长而改善。[41] 数据、模型和评测协议不同,两项研究不能直接合并成统一结论;它们共同要求研究者验证代理指标与实际控制表现的关系。
误差累积与失败恢复
模仿学习的经典分析考虑了错误累积。若策略在专家状态上的单步错误率为 δ,一个长度为 T 的任务,其最坏情形累计代价差可以具有以下上界:
C(π̂) − C(πexpert) ≤ O(δ · T²)
这里假设单步代价有界,并采用相应的分类式错误定义。早期一次错误可能使策略进入训练中罕见的状态,影响余下许多步;任务越长,这种影响累积的机会越多。[42]
这个界刻画的是特定假设下的最坏情况。关于模仿学习样本复杂度的研究进一步讨论了状态转移是否已知、策略类别和专家条件的作用。[43] Foster 等人的分析则表明,在可实现性、累计回报范围和策略学习复杂度等条件得到控制时,使用对数损失的行为克隆可以得到更好的时长依赖。[44] 连续控制任务不能直接套用二次增长作为实测规律。
部署中的恢复数据因此有单独价值。只记录成功演示,可能漏掉夹爪滑动、拿偏或位置偏离之后如何继续。把这些状态、纠正动作和任务结果补进训练,才能检验策略是否学会恢复。[5]
补充阅读:闭环评测的样本量
下面讨论怎样判断几次闭环测试中的差异是否可信。这影响泛化收益的测量,与前面讨论的动作学习机制分别处理。
闭环评测需要摆放物体、运行策略、检查结果,再把环境复位。仿真能够降低一部分成本;真实物体的损坏、状态变化和人工判断仍会影响真机测试速度。
如果把每次试验近似看成独立、同分布的成功或失败,用正态近似估计成功率所需的试验数:
N ≈ p(1 − p) · (1.96 / w)²
p 是预期成功率,w 是 95% 置信区间的目标半宽。取 p = 0.9、w = 0.02,近似需要 864 次试验。NVIDIA 的评测文章给出一个精确二项区间的例子:1,030 次试验、观测成功率 90% 时,Clopper–Pearson 区间约为 88.0% 至 91.8%。[45]
这里的区间只描述所测试条件下的抽样不确定性。换一个家庭、物体或任务,不能继续沿用同一个成功率和区间。
样本量较小时,模型排名也容易不稳定。文中的模拟把两个策略的真实成功率设为 80% 和 75%,重复比较四万次。每个策略只测十次时,把较差策略排在前面或判成平手的概率约为一半;各测二十次时约为 42%,各测一百次时仍约为 22%。[21] 这里把平手计入“未能区分”,与单纯判错的概率有所区别。
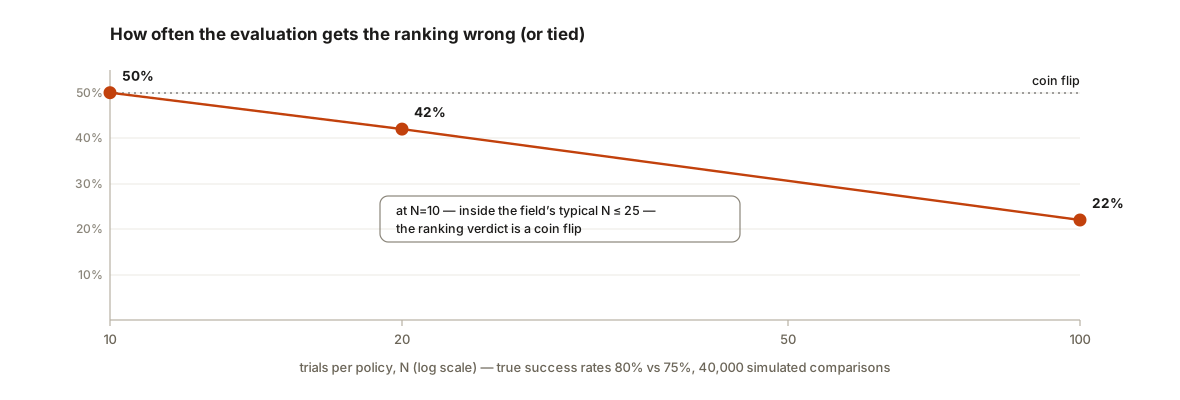
作者的二项试验模拟。纵轴把错误排名与平手合计,说明小样本可能无法稳定区分五个百分点的真实差异。[21]
PhAIL 对真实机器人 VLA 评测实践的调查提到,许多评测每个条件的执行次数不超过二十五,且缺少置信区间。[46] 因而,比较相近模型时,需要同时报告试验数、区间、任务差异与失败类型。
仿真与自动化能减少这项负担。SIMPLER 在其测试范围内得到较高的仿真与真机策略排名相关性,但明确限定于现有模拟器能合理近似的大体刚性物体任务。[47] AutoEval 探索自动化的真实机器人评测。[48] 对布料、柔软物体和复杂接触,仍需要单独验证仿真是否足以比较策略。
参考文献(点击展开)
- Dyna Robotics,“Dyna-2: A 1-Million-Hour Scaling Law for World-Action Models”,2026 年 8 月。dyna.co/dyna-2。训练目标消融使用带手部姿态标注的人类视频;零样本离线评测与任务后训练后的真机评测为不同实验。
- Brohan 等(Google DeepMind),"RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control",2023(55B 参数,PaLI-X 主干)。arXiv:2307.15818
- Kim 等,"OpenVLA: An Open-Source Vision-Language-Action Model",2024(7B 参数;评测中超过 55B 的 RT-2-X)。arXiv:2406.09246
- Black 等(Physical Intelligence),"π0: A Vision-Language-Action Flow Model for General Robot Control",2024(约 3B 参数)。arXiv:2410.24164
- Physical Intelligence,"π*0.6: a VLA That Learns From Experience"(RECAP),2025。arXiv:2511.14759 · pi.website/blog/pistar06
- Li, Zhang 等,"VLA Models Are More Generalizable Than You Think: Revisiting Physical and Spatial Modeling",2025(视角转移的失败定位到视觉 token,可用一个小适配器修复,而策略保持冻结)。arXiv:2512.02902
- Driess 等(Physical Intelligence),“Knowledge Insulating Vision-Language-Action Models: Train Fast, Run Fast, Generalize Better”,2025。arXiv:2505.23705。分析连续动作模块对主干训练和知识迁移的影响。
- Kaplan 等,"Scaling Laws for Neural Language Models",2020。arXiv:2001.08361
- Hoffmann 等,"Training Compute-Optimal Large Language Models"(Chinchilla),NeurIPS 2022。arXiv:2203.15556
- Mandlekar 等,"Scaling Robot Supervision to Hundreds of Hours with RoboTurk: Robotic Manipulation Dataset through Human Reasoning and Dexterity",IROS 2019(111+ 小时遥操作)。arXiv:1911.04052
- Khazatsky 等,"DROID: A Large-Scale In-The-Wild Robot Manipulation Dataset",RSS 2024(76k 轨迹,约 350 小时)。arXiv:2403.12945
- Bu 等(AgiBot),"AgiBot World Colosseo: A Large-scale Manipulation Platform for Scalable and Intelligent Embodied Systems",2025(1M+ 轨迹,约 2,976 小时)。arXiv:2503.06669
- Yuan 等,"Qwen-RobotManip Technical Report: Alignment Unlocks Scale for Robotic Manipulation Foundation Models",2026(九个主要开源机器人数据集共约 11,000 小时)。arXiv:2606.17846
- Grauman 等,"Ego4D: Around the World in 3,000 Hours of Egocentric Video",CVPR 2022(3,670 小时)。arXiv:2110.07058
- Grauman 等,"Ego-Exo4D: Understanding Skilled Human Activity from First- and Third-Person Perspectives",CVPR 2024(1,286 视频小时)。arXiv:2311.18259
- Hoque 等(Apple),"EgoDex: Learning Dexterous Manipulation from Large-Scale Egocentric Video",2025(829 小时,338k 回合)。arXiv:2505.11709
- Generalist AI,"GEN-0",2025 年 11 月(270K+ 小时操作数据,每周约增长 10K 小时)。generalistai.com/blog/gen-0
- Generalist AI,"GEN-1",2026("预训练数据集不含机器人数据";可穿戴设备语料)。generalistai.com/blog/gen-1
- 小米机器人团队,"Xiaomi-Robotics-1: Scaling Vision-Language-Action Models with over 100K Hours of Real-World Trajectories",2026。arXiv:2607.15330
- NVIDIA,"GR00T N1: An Open Foundation Model for Generalist Humanoid Robots",2025(2.2B 参数)。arXiv:2503.14734
- 作者的二维绕障与统计仿真,2026。包括隐藏变量消融、局部条件方差估计、训练曲线、回合与帧数对照、观测目标分解、开环与闭环对照、评测抽样和粘滑模拟。正文给出单步更新示例,完整实验脚本尚未随文公开;具体数值限于相应仿真设置。
- “FACT: Demystifying When and Why VLAs Fail in Contact-Rich Tasks and How to Fix Them”,2026。arXiv:2608.01402。分析接触密集任务中的力控制与其他失效因素。
- Niu 等,“T-Rex: Tactile-Reactive Dexterous Manipulation”,2026。arXiv:2606.17055。报告约 100 小时触觉操作数据。
- Bauza & Rodriguez,"A Probabilistic Data-Driven Model for Planar Pushing",2017(真实硬件上重复相同的推,产出一个结果分布)。arXiv:1704.03033
- Denton & Fergus,“Stochastic Video Generation with a Learned Prior”,ICML 2018。arXiv:1802.07687。用随机潜变量建模视频中不确定的未来。
- Bruce 等(Google DeepMind),"Genie: Generative Interactive Environments",ICML 2024(一个在未标注互联网视频上训练的世界模型,从未见过动作标签却学出一个可控的潜动作空间)。arXiv:2402.15391
- Zhang 等,"Understanding Deep Learning Requires Rethinking Generalization",ICLR 2017。arXiv:1611.03530
- Arpit 等,“A Closer Look at Memorization in Deep Networks”,ICML 2017。arXiv:1706.05394。研究深度网络学习规律与记忆训练样本的过程。
- Chi 等,"Diffusion Policy: Visuomotor Policy Learning via Action Diffusion",RSS 2023。arXiv:2303.04137
- Lin、Hu 等,“Data Scaling Laws in Imitation Learning for Robotic Manipulation”,ICLR 2025。arXiv:2410.18647。研究环境、物体及演示数量对泛化的影响,包含四万多条演示与一万五千多次真机执行测试。
- 丰田研究院等,“A Systematic Study of Data Modalities and Strategies for Co-training Large Behavior Models for Robot Manipulation”,2026。arXiv:2602.01067。比较 89 个策略,包含 58,000 次仿真与 2,835 次真实机器人执行测试。
- Shi, Chen 等(AgiBot),"Is Diversity All You Need for Scalable Robotic Manipulation?",2025(任务多样性胜过单任务数量;操作员多样性去偏有帮助)。arXiv:2507.06219
- Saxena, Bronars 等,"What Matters in Learning from Large-Scale Datasets for Robot Manipulation"(MimicLabs),ICLR 2025。arXiv:2506.13536
- Zheng 等,"Data Scaling Laws for Imitation Learning-Based End-to-End Autonomous Driving",2024(开环幂律,r = −0.963,未能迁移到闭环)。arXiv:2412.02689
- 作者基于 Dyna-2 公开规模点所作的带渐近项曲线拟合与自助法计算,2026。外推对拟合形式和渐近项敏感,完整计算脚本尚未随文公开,不作为规模门槛或到达时间的预测。
- Generalist AI,“GEN-1.5: Embodied Foundation Models are One-Shot Learners”,2026 年 8 月。generalistai.com/blog/gen-1.5。短演示上下文适配平均成功率为 59%,每任务五分钟数据微调后为 83%;报告中的 ±10% 与 ±9% 均为标准差。
- Wen 等,"Fighting Copycat Agents in Behavioral Cloning from Observation Histories",NeurIPS 2020。arXiv:2010.14876
- de Haan, Jayaraman & Levine,"Causal Confusion in Imitation Learning",NeurIPS 2019。arXiv:1905.11979
- Zhou 等,“LIBERO-PRO: Towards Robust and Fair Evaluation of Vision-Language-Action Models Beyond Memorization”,2025。arXiv:2510.03827。评估物体、初始状态、任务指令和环境扰动下的模型表现。
- Xing 等,"Shortcut Learning in Generalist Robot Policies: The Role of Dataset Diversity and Fragmentation",CoRL 2025。arXiv:2508.06426
- Baniodeh 等(Waymo),“Scaling Laws of Motion Forecasting and Planning”,2025。arXiv:2506.08228。使用五十万小时驾驶数据,报告其设置下闭环指标随规模改善。
- Ross & Bagnell,“Efficient Reductions for Imitation Learning”,AISTATS 2010。PMLR 9:661–668。分析行为克隆中的错误累积;后续 DAgger 工作见 Ross、Gordon & Bagnell,2011,arXiv:1011.0686。
- Rajaraman 等,“Toward the Fundamental Limits of Imitation Learning”,NeurIPS 2020。arXiv:2009.05990。分析不同策略和环境假设下模仿学习的样本复杂度。
- Foster、Block & Misra,“Is Behavior Cloning All You Need? Understanding Horizon in Imitation Learning”,NeurIPS 2024。arXiv:2407.15007。在可实现性、累计回报范围和策略类别复杂度等条件下,分析对数损失的时长依赖。
- NVIDIA 技术博客,“How to Evaluate General-Purpose Robot Policies for Real-World Deployment”,2026。developer.nvidia.com。讨论评测指标、试验数量与 Clopper–Pearson 置信区间。
- Sergey Arkhangelskiy,"PhAIL: A Real-Robot VLA Benchmark and Distributional Methodology",2026(评测实践调查:真实机器人 VLA 评测"仍建立在固定超时下的二值成功率、每条件 N ≤ 25 次滚动、几乎总是不带置信区间"之上)。arXiv:2605.29710
- Li 等,"Evaluating Real-World Robot Manipulation Policies in Simulation"(SIMPLER),CoRL 2024。arXiv:2405.05941 · simpler-env.github.io
- Zhou 等,"AutoEval: Autonomous Evaluation of Generalist Robot Manipulation Policies in the Real World",2025。arXiv:2503.24278
引用本文
如需引用本文,请使用以下格式:
Yex Ling. “为什么机器人还只是一个遥控大玩具”. yexling.com (2026年8月). https://yexling.com/zh/blog/action-bottleneck/
或使用 BibTeX:
@article{yexling2026zhactionbottleneck,
  title = {为什么机器人还只是一个遥控大玩具},
  author = {{Yex Ling}},
  journal = {yexling.com},
  year = {2026},
  month = {August},
  url = {https://yexling.com/zh/blog/action-bottleneck/}
}